Replikasyon Krizi: Bilimsel Verilere Güvenebilir miyiz?
En çok alıntılanan bulguların bile aynı sonucu vermediği ortaya çıktığında bilim kendi güvenilirliğini sorgulamak zorunda kaldı.
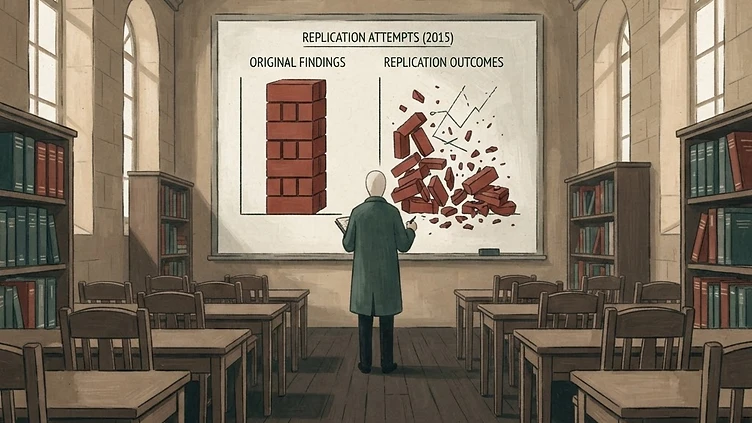
Bir bulguya güvenmekle bir bulguyu doğru bulmak arasında nasıl bir fark var, diye sormuşumdur kendime uzun zaman. Gazetede okuduğum bir araştırma başlığı, "mutluluğun formülü bulundu" ya da "hafızayı güçlendiren basit alışkanlık" gibi bir cümleyle karşıma çıktığında, önce inanırım, sonra şüphelenirim, sonunda unuturum. Oysa bilim dediğimiz şey, tam da bu üç aşamanın ötesinde bir şey vadeder bize: tekrar edilebilirlik. Bir deney bir kez doğru çıktıysa, aynı koşullarda yeniden denendiğinde de aynı sonucu vermeli, değil mi? 2015 yılında yapılan büyük ölçekli bir çalışma, bu basit ama hayati varsayımı sarstı ve psikoloji biliminin en parlak bulgularının bile ikinci kez aynı ışığı vermediğini gösterdi. Bu denemede, o sarsıntının nereden geldiğini, neden büyüdüğünü ve bilim camiasının bunu nasıl bu kadar uzun süre görmezden gelebildiğini anlamaya çalışacağım.
Sihirli Eşik: p<0.05'in Tuzağı
Yirminci yüzyılın başında bir istatistikçi, bir sonucun tesadüf eseri olup olmadığını anlamak için pratik bir eşik önerdi: eğer bir bulgunun sadece şans eseri ortaya çıkma olasılığı yirmide birden azsa, bu bulguyu dikkate almaya değer sayalım. Basit, kullanışlı, geçici bir kuraldı bu; bir kapıyı açmak için kullanılan bir anahtar gibiydi, kapının kendisi değildi. Ama zamanla bu anahtar, kapının ta kendisi hâline geldi. Araştırmacılar artık doğayı anlamaya değil, o sihirli eşiğin altına inmeye çalışıyordu; çünkü akademik dünyada bir bulgunun "anlamlı" sayılması için gereken tek şey, o küçük sayıyı elde etmekti. Düşünsenize, bir laboratuvarda aylarca süren bir deneyin kaderi, virgülden sonra üçüncü hanede duran bir rakama bağlanıyor. Bu kadar keskin bir sınırın, doğanın kendisi kadar keskin olduğunu kim söyleyebilir?
Burada işin can alıcı tarafı şu: bir araştırmacı elindeki veriyi farklı şekillerde kesip biçtiğinde, farklı değişkenleri denediğinde, farklı alt grupları incelediğinde, er ya da geç o eşiğin altına inen bir kombinasyon bulur. Buna istatistikçiler "çatallanan yollar bahçesi" gibi şiirsel bir ad takmış; ben buna daha sade bir benzetme kullanmayı seviyorum: elinizde yeterince zar varsa, er ya da geç istediğiniz sayıyı atarsınız. Kötü niyetli bir hile değil bu çoğu zaman; araştırmacı kendi hipotezine inanıyor, verisini "doğru" şekilde okumaya çalışıyor, ama o çabanın kendisi sonucu çarpıtıyor. Eşik, bilimsel keşfin aracı olmaktan çıkıp hedefin kendisi olduğunda, keşfedilen şeyin gerçekliği de gölgede kalıyor.
2015'in Soğuk Duşu: Büyük Tekrar Deneme Çalışması
İşte bu noktada, 2015 yılında geniş bir araştırmacı topluluğu kolları sıvadı ve psikoloji alanında yayımlanmış yüz çalışmayı, orijinal yöntemlerine olabildiğince sadık kalarak yeniden test etti. Amaç basitti: bu bulgular, ilk kez bulundukları gibi, bir kez daha aynı etkiyi verecek miydi? Sonuç, alanı sarsan bir soğuk duştu. Çalışmaların önemli bir kısmı, ilk seferinde gözlemlenen etkiyi ikinci kez üretemedi; üretebilenlerin de etkisi genellikle çok daha küçük çıktı. Bir zamanlar ders kitaplarına girecek kadar ünlenmiş bazı bulgular, ikinci denemede sessizce eriyip gitti. Bu, sadece birkaç zayıf çalışmanın başarısızlığı değildi; alanın bütününe dair bir soru işaretiydi.
Beni asıl düşündüren, bu sonucun nasıl karşılandığıydı. Bazı araştırmacılar hemen savunmaya geçti: tekrar deneme çalışmaları orijinal koşulları tam olarak yakalayamaz, farklı örneklemler farklı sonuçlar verebilir, kültürel bağlam değişmiştir, dediler. Bu itirazların bir kısmında haklılık payı var elbette; bilim statik bir şey değil, bağlamdan tamamen bağımsız da değil. Ama bu açıklama, neden ilk bulunan etkilerin sistematik olarak daha büyük, daha çarpıcı, daha "yayımlanabilir" çıktığını açıklamıyor. Eğer mesele sadece bağlam farkı olsaydı, sonuçların bazen daha büyük bazen daha küçük çıkmasını beklerdik; oysa örüntü hep aynı yöne işaret ediyordu: ilk bulgu her zaman daha parlaktı, ikincisi her zaman daha sönük. Bu, rastlantıyla açıklanamayacak kadar düzenli bir sapmaydı ve bize bir şeyin, bulgunun kendisinden önce, bulgunun seçilme sürecinde bozulduğunu söylüyordu.
Yayımla Yoksa Yok Ol: Teşvik Sisteminin Bedeli
Peki bu seçilme süreci nerede gerçekleşiyor? Cevap, laboratuvarın dışında, akademik kariyerin kendi mantığında saklı. Bir araştırmacının işini elinde tutması, bir sonraki pozisyona geçmesi, fon alması, genellikle tek bir ölçüte bağlı: yayın sayısı ve bu yayınların çarpıcılığı. Sıradan bir sonuç, "aradığımız etkiyi bulamadık" diyen dürüst bir makale, hiçbir dergi tarafından heyecanla karşılanmaz; bu tür çalışmalar çekmecelerde kalır, kimse okumaz, kimse alıntılamaz. Oysa "x davranışı insanları yüzde otuz daha dürüst yapıyor" diyen bir başlık, hem dergilerin hem gazetelerin ilgisini çeker. Sistem, farkında olmadan, araştırmacıları çarpıcı ve pozitif sonuç üretmeye itiyor; çünkü hayatta kalmanın bedeli bu.
Genç bir akademisyenin konumunu düşünün: elinde üç yıllık bir veri seti var, beklediği etkiyi tam olarak bulamamış, ama kariyerinin bu aşamasında yayın yapması gerekiyor. Ne yapar? Belki verisini biraz farklı açılardan inceler, belki alt grupları ayırır, belki en "umut verici" sonucu öne çıkarır. Kötü niyetli değildir bu kişi; sistemin ona sunduğu tek rasyonel seçenek budur. Negatif sonuçlar, "başarısız" denemeler, kaydedilmeyen tekrar denemeler, bir tür görünmez arşivde birikir; buna bazıları "çekmece problemi" der. Sonuçta literatürde kalan şey, gerçekliğin kendisi değil, gerçekliğin en çarpıcı, en pozitif, en "yayımlanabilir" kesiti olur. Kriz bu yüzden bu kadar uzun süre fark edilmedi; çünkü her tek tek çalışma kurallara uygun görünüyordu, ama bütünün toplamı bir yanılsama üretiyordu.
Bütün bunların ardında yatan asıl soru, kötü araştırmacıların mı yoksa kötü teşviklerin mi sorumlu olduğu değil bence; ikisi de aynı madalyonun iki yüzü. Bir sistemde, dürüst ve sıradan bir sonuç üretenle verisini biraz zorlayıp çarpıcı bir sonuç üretenin aynı ödülü almadığı bir yerde, zamanla sadece ikinci tür davranış hayatta kalır. Bu, doğal seçilime benzer bir süreç; en "uygun" fikirlerin değil, en "satılabilir" fikirlerin hayatta kalması. 2015'in tekrar deneme çalışması, bu seçilim baskısının sonuçlarını gözümüze soktu ve bilim camiasına rahatsız edici bir soru bıraktı: eğer en ünlü bulgularımız bile bu baskıdan payını almışsa, güvendiğimiz bilgi gerçekte ne kadar sağlam?
Bu denemeyi karamsar bir notla bitirmek istemem, çünkü kriz aynı zamanda bir uyanışı da doğurdu. Önceden kayıt sistemleri, açık veri paylaşımı, tekrar deneme çalışmalarına verilen artan değer, bilimin kendi hatasını fark edip düzeltme kapasitesine sahip olduğunu gösteriyor bana. Belki de bilimin gücü, hiçbir zaman yanılmamasında değil, yanıldığını kabul edip yöntemini yeniden kurabilmesinde. 2015'teki o soğuk duş, acı vericiydi ama gerekliydi; çünkü bir disiplinin kendi aynasına dürüstçe bakması, ne kadar can yaksa da, o disiplini daha güvenilir kılan tek yoldur.
İlgili Denemeler
İnsan Beyni Manyetik Alanı Hissedebilir mi?
Caltech'li jeofizikçi Joseph Kirschvink'in deneyi, insan beyninin manyetik alanlara tepki verdiğini gösterdi; peki bu altıncı bir his mi?
Jan Hendrik Schön: Bilim Dünyasını Kandıran Dahi
Jan Hendrik Schön'ün Bell Labs'teki sahte veri skandalı, bilimsel hakemlik sisteminin kör noktalarını nasıl gözler önüne serdi?
Barry Marshall Mide Ülseri Bakterisini Kanıtlamak İçin Kendini Enfekte Etti
Barry Marshall, mide ülserinin stresten değil bir bakteriden kaynaklandığını kanıtlamak için kendi midesine zararlı bakteriyi içerek tıp tarihine geçti.
Tartışma (0)
Henüz yorum yok. İlk yorumu siz yapın.
Bültene katıl
Yeni denemeler haftada bir e-posta kutuna gelsin.